Thứ Bảy, 5 tháng 12, 2020

Thuật giải di truyền và ứng dụng giải bài toán siêu trí tuệ Việt Nam

Heey yo 500 anh em, lâu lắm rồi mới quay trở lại viết blog. Cũng tại là dạo gần đây mình tập trung làm content bên mảng youtube nhiều quá, nên không sắp xếp đươc thời gian để viết bài bên đây. Nhưng cơ duyên là đợt rồi mình có đọc 1 cuốn sách liên quan đến trí tuệ nhân tạo, nói chung cuốn sách chủ yếu nói về việc trí tuệ nhân tạo sẽ thống trị loài người vân vân mây mây (mà mình cũng có review cuốn sách đó ở đây, anh chị em thấy hứng thú thì vào xem nhé). Sau khi đọc cuốn sách này thì mình lại có hứng để viết blog, thế là bài viết này ra đời =))
Ok, không dài dòng nữa, cùng mình tìm hiểu xem thuật giải di truyền là gì nhé, và cùng nhau code 1 chương trình giải 1 bài toán xuất hiện trong chương trình siêu trí tuệ Việt Nam mùa 2.
Các ứng dụng mình viết trong bài này đều đã được host lên ở đây, các bạn có thể vào xem nhé.

Thuật giải di truyền (Genetic Algorithm)

Để hiểu thuật giải di truyền là gì, thì chúng ta cần phải biết được thuyết tiến hóa của Darwin trước đã, vì thuật giải này được lấy ý tưởng từ thuyết tiến hóa này.
Theo Darwin, tiến hóa loài được hình thành do sự kết hợp của 3 yếu tố quan trọng: di truyền, đột biến và chọn lọc tự nhiên ( Cái này mình nhớ vì hồi xưa cấp 3 mình học chuyên sinh mà =)) ).
Lấy ví dụ loài bướm tiêu trong việc tiến hóa theo chọn lọc tự nhiên:
Ngày xửa ngày xưa, ở Anh có 1 đàn bướm tiêu, chúng là một đàn có nhiều con, và phần lớn chúng có màu đen và trắng.
Và để duy trì nòi giống, chúng phải giao phối với nhau, đây là quá trình di truyền. Và như chương trình sinh học cấp 3 đã dạy cho chúng ta biết, khi giao phối với nhau, thực chất là sự kết hợp của các cặp nhiễm sắc thể để tổng hợp tính trạng giữa bố và mẹ cho đứa con yêu dấu.
Nhưng, đây cũng là lúc những tác nhân môi trường khắc nhiệt của chúng ta phát huy tác động, và làm cho quá trình kết hợp này bị đột biến. Đột biến đã làm cho con con có những đặc tính không giống như bố mẹ mình.
Thế nên, trong đàn bướm trắng đen có xuất hiện những con bướm màu hường mộng mơ. Những con bướm màu hường này, thật là sặc sỡ, nó có thể dễ bị ăn thịt hơn, vì những con chim có thể phát hiện nó dễ dàng hơn. Thật tội nghiệp.
Nhưng, một ngày đẹp trời, có một dũng sĩ tên là Cuonglv1109 tới vùng đất loài bướm đang sống, và vẽ graffity. Dũng sĩ này cũng thuộc trường phái màu hường, do đó cả vùng đất bỗng chốc trở thành màu hường.
Và lúc này, những con bướm màu hường lại đạt được lợi thế. Những con bướm trắng và đen lại dễ bị tiêu diệt hơn vì quá dễ bị phát hiện. Và đây, Darwin gọi nó là chọn lọc tự nhiên.
Lúc này, trong quần thể con bướm số lượng bướm hường nhiều hơn, nên các con đời sau cũng dễ sinh ra có màu hường hơn.
Thế là, nhờ có dũng sĩ Cuonglv1109, đàn bướm từ trắng đen đã chuyển qua màu hường.
Và đó là thuyết tiến hóa của Darwin, vậy thì nó liên quan gì tới thuật giải di truyền. Ồ, hóa ra các nhà khoa học đã áp dụng thuyết tiến hóa để tạo nên thuật giải di truyền. Ví dụ, chúng ta đang muốn giải quyết một bài toán đơn giản là mò password. Password này gồm có 11 kí tự, chỉ cần đoán đúng 11 kí tự không cần theo thứ tự là sẽ giải được password. Ví dụ password cần giải là cuonglv1109.
Thuật giải di truyền sẽ tạo ra 1 quần thể gồm các password ngẫu nhiên có 11 kí tự. Ví dụ ở đây, ta có quần thể gồm 6 cá thể.
Những cá thể gần giống với password gốc nhất, là những cá thể có cơ hội sống cao hơn qua thế hệ sau, những cá thể khác với password nhất thì sẽ bị chết. Đây chính là chọn lọc tự nhiên.
Những cá thể sống sót sẽ giao phối với nhau, và sản sinh ra thế hệ con. Đây là quá trình di truyền.
Một vài cá thế con bị đột biến làm thay đổi 1 kí tự.
Thế hệ thứ 2 theo thuyết tiến hóa đã có độ chính xác cao hơn so với thế hệ đầu tiên. Quá trình này lặp đi lặp lại qua các thế hệ sẽ dẫn tới kết quả tìm ra được password.
Và đó chính là thuật giải di truyền.
Trong thuật giải di truyền có nhiều yếu tố cần phải xem xét. Trong đó có 2 yếu tố mà mình thấy quan trọng đó là:
Độ đột biến (mutation rate): tức là độ đột biến trong quần thể của bạn. Đây thực chất cũng là hyperparameter cần phải tối ưu.
Độ chọn lọc (Selection Rate): tức là mức độ chọn lọc cá thể, bao nhiêu cá thể phải chết đi.
Mình cũng đã viết 1 cái demo cho thuật giải này dựa trên câu chuyện đàn bướm ở trên.
Ý tưởng đơn giản là chúng ta có 1 đàn bướm ngẫu nhiên gồm nhiều con bướm với màu sắc khác nhau. Sau đó ta chọn màu cho môi trường chúng sống, qua các thế hệ thì những con bướm này sẽ chuyển thành màu gần gần giống với màu của môi trường. Cái demo này thì mình sẽ không giải thích code nha, tại nó sẽ tốn khá nhiều thời gian, mình sẽ dành thời gian để nói về ứng dụng giải bài toán siêu trí tuệ Việt Nam ở dưới. Code của demo này mình cũng đã push lên github ở đây, các bạn có thể clone về chạy thử
Vậy thì thuật giải di truyền này áp dụng được vào việc gì?
Như các bạn để ý, thuật giải di truyền này qua mỗi thế hệ, thì các cá thế ở thế hệ sau có độ chính xác cao hơn các cá thể ở thế hệ trước. Điều này sẽ được áp dụng vào việc tìm ra các hyperparameter trong máy học(Nếu như các bạn không hiểu hyperparameter, máy học là gì, thì có thể quay lại series nhận dạng hình ảnh bằng máy học do mình đã viết để đọc nhé). Vậy nên, người ta sẽ áp dụng thuật giải di truyền này vào máy học để máy có thể học đươc hiệu quả.
Nhưng hôm nay, mình sẽ áp dụng thuật giải di truyền này vào để giải một bài toán vừa mới được chiếu trên chương trình siêu trí tuệ Việt Nam mùa 2.

Ứng dụng giải bài toán siêu trí tuệ Việt Nam

Trong chương trình siêu trí tuệ Việt Nam mùa 2, mình có thấy 1 bài toán về mã đi tuần. Trong đó, thí sinh được cho 1 bàn cờ vua 8*8, và 2 ô bắt đầu và kết thúc.
Nhiệm vụ của tuyển thủ là phải giải bài mã đi tuần và bài toán điền số. Với bài toán mã đi tuần, các bạn có thể giải bằng back-tracking (mình đã viết ở trong bài này). Mà thực ra mình nói vậy thôi, chứ sau khi mình thử code thì thấy dùng back-tracking chạy lâu lắm các bạn ạ =(( .
Ở đây, chúng ta sẽ giải quyết bài toán thứ 2. Đó là phải điền số vào các ô trong bàn cờ sao cho: Tổng mỗi hàng, tổng mỗi cột phải bằng với 1 số cho trước bất kì (trong chương trình, con số này được ca sĩ Tóc Tiên chọn là 531)
Để giải quyết bài toán này, ý tưởng mình đưa ra đó là chúng ta sẽ tạo ra 1 quần thể những bàn cờ, với những con số bất kì được đặt trong bàn cờ đó. Ở đây mình tạo ra 1 quần thể có 1000 bàn cờ.
this.result = 531;
this.insta = 1000;        
this.mazes = [this.insta];
for(let i = 0; i< this.insta; i++) {
    this.mazes[i] = new Maze(result);
}
Sau đó chúng ta sẽ tính độ fit của mỗi cá thể so với kết quả đúng. Cách tính thì mình sẽ tính bằng cách tính tổng sự sai số của mỗi hàng, mỗi cột của bàn cờ. Cá thể có độ sai số càng cao, thì đột fit càng thấp. Tức là vào thế hệ sau sẽ càng dễ bị chết đi.
calculateScore(result){
        this.score = 0; // fitness score
        for (let i = 0; i < 8; i++) {
            let total = 0;
            for (let j = 0; j < 8; j++) {
               total += this.map[i][j];
            }
            this.score += Math.abs(result- total);
        }
        for (let i = 0; i < 8; i++) {
            let total = 0;
            for (let j = 0; j < 8; j++) {
                total += this.map[j][i];
            }
            this.score += Math.abs(result- total);
        }
    }
Độ chọn lọc mình đưa ra là 80% số lượng cá thể. Tức là sau mỗi thế hệ, sẽ có 800/1000 cá thể bị loại bỏ.
this.deathRate = 0.8*this.insta;
selection(){
        for(let i = 0 ; i < this.insta; i++){
            this.mazes[i].calculateScore(this.result);
        }
        this.mazes.sort((a, b) => a.score - b.score); //sort by fitness
        for(let i = this.mazes.length - this.deathRate; i < this.mazes.length; i++){ > 
            this.mazes[i].score = -1;
        }
    } <
Sau khi loại bỏ các cá thể, mình cho 200 cá thể còn lại lai tạo với nhau. Lai tạo ở đây là mình lấy giá trị trung bình của cha và mẹ cho đứa con
crossOverAndMutation(far, mom){
        for (let i = 0; i < 8; i++) {
            for (let j = 0; j < 8; j++) {
                this.map[i][j] =  Math.floor((far.map[i][j] + mom.map[i][j])/2);                
            }
        }
    }
Cuối cùng là quá trình đột biến. Ở đây mình cho đột biến bằng cách: Nếu giá trị của cha và mẹ khác nhau (tức là chưa tối ưu) thì mình sẽ chắc chắn cho đột biến tại ô đó +-2. Còn nếu giá trị của cha và mẹ giống nhau ( có sự tối ưu) thì mình cho tỉ lệ đột biến tại ô đó là 1% (với giá trị đột biển +- 1).
crossOverAndMutation(far, mom){
        for (let i = 0; i < 8; i++) {
            for (let j = 0; j < 8; j++) {
                this.map[i][j] =  Math.floor((far.map[i][j] + mom.map[i][j])/2);
                if(far.map[i][j]!=mom.map[i][j]){
                    let randNum = Math.floor(Math.random() * 4) ;
                    if(randNum%2==0){
                        this.map[i][j] +=2;
                    } else {
                        this.map[i][j] -= 2;
                    }
                } else {
                    let randNum = Math.floor(Math.random() * 100)
                    if(randNum===51){
                        this.map[i][j] +=1;
                    } else if(randNum===52){
                        this.map[i][j] -=1;
                    }
                }
                if(this.map[i][j]<=0){
                    this.map[i][j] =  1;
                }

            }
        }
    }
Quá trình chọn lọc tự nhiên, di truyền và đột biến cứ tiếp tục lặp đi lặp lại. Kết quả là chúng ta sẽ có được thế hệ sau, có bàn cờ giống với bàn cờ cần tìm nhất. Và khi xuất hiện một bàn cờ cần tìm (tức lúc này sai số = 0), thì chúng ta sẽ dừng lại.
while(true){
if(geneticAlgorithm.mazes[0].score == 0) {
                return;
            }
            geneticAlgorithm.selection();            
            geneticAlgorithm.crossOverAndMutation();
}
Tất cả code của ứng dụng này mình push hết lên đây rồi. Các bạn có thể lấy về chạy thử nhé.
Share:

Thứ Bảy, 15 tháng 2, 2020

Tìm hiểu thuật toán Backtracking và ứng dụng giải Sudoku

 Mình để ý là trên blog mình viết khá nhiều thuật toán về AI, viết cả về máy học. Và như các bạn cũng thấy, những thuật toán này giải được những bài toán khá phức tạp, và do đó những thuật toán này cũng phức tạp không kém :)). Nhưng đã bao giờ bạn nghĩ chúng ta có thể giải những bài toán phức tạp bằng sức mạnh lưu trữ và tốc độ tính toán của máy tính chưa? Chúng ta sẽ không phải cất công suy nghĩ quá nhiều về thuật toán nữa. Máy tính sẽ lo hết cho chúng ta. ( Viết tới đây thì mình cũng thấy nó na ná như là máy học thật ^^)
 Hôm nay mình sẽ giới thiệu các bạn 1 thuật toán có tên là Backtracking, một thuật toán siêu đơn giản nhưng sức mạnh của nó thì vô cùng lớn.
Các ứng dụng mình viết trong bài này đều đã được host lên ở đây, các bạn có thể vào xem nhé.

Backtracking là gì?

Backtracking algorithm là kĩ thuật sử dụng các tổ hợp phép thử để giải quyết 1 vấn đề tính toán nào đó

Để dễ hiểu, ta đi vào ví dụ về mở khóa mã pin chẳng hạn. Ta có 1 mã pin có 4 chữ số từ 0-9. Để giải được mã pin này, thì có 1 cách đơn giản đó là phải thử nghiệm từng khả năng để xem có đúng không.

Đầu tiên ta có thể điền vào ô đầu là số 0.
Tiếp tục điền vào các ô tiếp theo.
Giả sử mã pin 0000 là mã pin sai. Vậy bước tiếp theo của backtracking là gì? Câu trả lời là thuật toán này sẽ thử khả năng tiếp theo của ô cuối cùng. Và ta sẽ có mã pin tiếp theo như sau
Và nếu mã pin 0001 cũng là mã pin sai. Chúng ta sẽ từ từ tăng giá trị hàng đơn vị lên 1 đơn vị. Ta sẽ có các mã pin từ 0002 đến 0009.
Vấn đề là các mã pin trên đều sai. Lúc này, backtracking sẽ quay lại ô trước hàng đơn vị. Đây cũng là lí do thuật toán này mang tên backtracking ( truy vết). Ta sẽ có mã pin được nhập như sau.
Lúc này, quá trình thử nghiệm lại tiếp tục với số hàng đơn vị, ta sẽ có các mã pin từ 0010 đến 0019. Và nếu những mã pin này sai, thì backtracking lại tiếp tục để cho ra các số 0020 đến 0029.
Cứ như thế, quá trình chạy sẽ kiểm thử các mã pin từ 0000 đến 9999. Và tất nhiên, khi mã pin đúng thì thuật toán sẽ kết thúc.

Ứng dụng giải sudoku bằng backtracking

Tương tự như việc giải mã pin, backtracking sẽ được chúng ta áp dụng để giải ma trận sudoku.
Chúng ta sẽ áp dụng kiểm thử từng khả năng của mỗi ô. Quá trình này sẽ kết thúc khi ta đạt được ma trận đúng của sudoku.

solve(maze){
        let currentCell = maze.getNextUnsolveCell();
        //already solved maze
        if(currentCell===undefined) {
            return true;
        }
        let availableValues = maze.getAvailableValues(currentCell);
        for(let value of availableValues){
            maze.setValueForCell(currentCell,value);
            if(this.solve(maze)){
                return true;
            }
        }
        maze.setValueForCell(currentCell,0);

        return false;
    }
Đoạn code trên chính là backtracking trong việc giải sudoku. Quá trình backtracking sẽ được thực hiện trong lập trình bởi đệ quy.
Các bước của thuật toán có thể được viết lại như sau:
Bước 1 : lấy ô chưa được giải tiếp theo để thử nghiệm
Bước 2: nếu không có ô nào để giải nữa thì ma trận đã giải xong
Bước 3: tìm những giá trị mà ô hiện tại có thể tồn tại. ( Thực ra bước này không cần thiết, bạn có thể cho các giá trị ứng thử từ 1 đến 9 cũng được. Mình thêm phần này  vào để tăng tốc độ tính toán lên thôi.)
Bước 4: với mỗi giá trị có thể ứng thử, ta ứng thử nó vào ô hiện tại.
Bước 5: thực hiện đệ quy lại từ Bước 1.
Bước 6: nếu đã thử hết tất cả giá trị ứng thử rồi mà không được thì reset lại ô hiện tại về 0
Các bạn để ý, thuật toán của chúng ta chẳng có gì là phức tạp cả. Nhưng nó đã giải quyết được 1 bài toán rất phức tạp là giải sudoku. Cái cốt lõi đằng sau việc này là chúng ta đã lợi dụng khả năng lưu trữ và tốc độ xử lý của máy tính để truy vết các phép thử.

Mình đã viết 1 ứng dụng để giải sudoku bằng javascript ( đoạn code demo ở trên đã thay đổi sau khi mình cập nhật hiệu ứng animation cho ứng dụng). Code các bạn có thể clone về ở github của mình.
Cám ơn các bạn đã ghé thăm và đọc bài trên blog của mình ^^
Share:

Chủ Nhật, 9 tháng 2, 2020

Thuật giải A* và ứng dụng tìm đường đi trong ma trận

 Hôm nay mình lại có nhã hứng làm 1 bài về AI. Và thứ mình muốn giới thiệu đó là thuật giải A*. Chúng ta sẽ đi tìm hiểu thuật giải A* này là gì và thử làm 1 cái app ứng dụng thuật giải này thử nhé.
Các ứng dụng mình viết trong bài này đều đã được host lên ở đây, các bạn có thể vào xem nhé.

Thuật giải A* là gì?

Thuật giải A* là thuật giải tìm đường đi ngắn nhất trong đồ thị. Đây là 1 giải thuật Heuristics, tức là đây là 1 giải thuật mang tính xấp xỉ, kết quả đầu ra có thể không hoàn toàn chính xác. Vậy câu hỏi đặt ra là: Tại sao không sử dụng một thuật giải tuyệt đối, kết quả đầu ra luôn luôn chính xác mà lại phải sử dụng thuật giải xấp xỉ như thế này?

Câu trả lời nằm ở chi phí tính toán. Để đưa ra được 1 kết quả chính xác, chúng ta phải vét cạn đồ thị ( nếu câu này sai thì mọi người hãy comment cho mình biết nhé), nhưng với thuật giải A*, nó không vét cạn, do đó, chi phí tính toán sẽ là thấp hơn.
Nói ra thì dài dòng, chốt lại là: Thuật giải A* là thuật giải tìm đường đi ngắn nhất trong đồ thị mà không vét cạn do đó mang tính xấp xỉ.

Thuật giải A* hoạt động như thế nào?

Trong thuật giải A*, mỗi 1 điểm trong đồ thị sẽ mang theo nó 3 giá trị cốt lõi:
   g: đây là chi phí cần phải bỏ ra để đi từ điểm bắt đầu đến điểm hiện tại.
   h: đây là chi phí ước lượng để đi từ điểm hiện tại đến điểm kết thúc.
   f : giá trị này thì dễ tính: f = g + h.
Dưới đây là thuật giải A*:
Input: 1 tập các điểm trong đồ thị với trọng số tương ứng. Node start và node end.
Output: Đường đi ngắn nhất từ node start đến node end.
Thuật giải gồm các bước sau đây:
B1: Khởi tạo 1 tập Open = rỗng . Khởi tạo tập Close = rỗng.
B2: Gán điểm Current = start để tính toán. Đưa điểm start vào tập Close.
B3: nếu current là end thì truy ngược lại đường đi dựa theo giá trị parent.
B4: Tìm tất cả những điểm lân cận (có thể đi được) từ điểm current và đưa vào 1 tập Neighbors. Duyệt qua từng điểm trong neighbors.
   B4.1: nếu điểm neighbor đang xét đã có trong tập Close => bỏ qua
             gán neighbor g = current g + cost(current, neighbor)                 
                    neighbor f = neighbor g + neighbor h.
                    neighbor parent = current
   B4.2: nếu điểm neighbor đang xet chưa có trong tập Open thì đưa neighbor vào tập Open
   B4.3: nếu neighbor đã có trong tập Open.
             Nếu neighbor trong open có g > neighbor g. Thì đưa neighbor vào thay thế cho neighbor trong open.
B5: Nếu Open còn phần tử thì lấy phần tử có f nhỏ nhất để làm current, đưa current vào tập close và quay lại bước 3.
B6: nếu Open rỗng thì không tìm được đường đi.

Chắc chắn đọc xong đoạn thuật giải trên các bạn chẳng hiểu được gì đâu. Vì vậy chúng ta  sẽ đi vào ví dụ cho dễ hiểu nhé:
Ta có đồ thị sau:
Điểm bắt đầu là A, điểm kết thúc là L. Với các giá trị h (ước lượng) của từng node tới L như sau:

POINT
h value
A
9
B
8
C
8
D
7
E
6
F
5
G
4
H
4
K
3
L
0
Bây giờ thì bắt đầu chạy thử thuật toán với ví dụ nhé:
Step
Open Set
Close Set
Current
Neighbors
Description
1
{}
{}
A(g=0, h=9, f=9)


2
{}
A(g=0, h=9, f=9)
A(g=0, h=9, f=9)
B(g=3,h=8,f=11, parent=A)
C(g=7,h=8,f=15, parent=A)
G(g=6,h=4,f=10,parent=A)

3
B(g=3,h=8,f=11, parent=A)
C(g=7,h=8,f=15, parent=A)
G(g=6,h=4,f=10,parent=A)
A(g=0, h=9, f=9)


Vì trong tập Open, G có f bé nhất nên lấy làm current.
4
B(g=3,h=8,f=11, parent=A)
C(g=7,h=8,f=15, parent=A)
A(g=0, h=9, f=9)
G(g=6,h=4,f=10,parent=A)
C(g=8,h=8,f=16,parent=G)
K(g=9,h=3,f=12,parent=G)

5
B(g=3,h=8,f=11, parent=A)
C(g=7,h=8,f=15, parent=A)
K(g=9,h=3,f=12,parent=G)
A(g=0, h=9, f=9)
G(g=6,h=4,f=10,parent=A)


Vì trong tập open, B có f nhỏ nhất nên lất làm current
6
C(g=7,h=8,f=15, parent=A)
K(g=9,h=3,f=12,parent=G)
A(g=0, h=9, f=9)
G(g=6,h=4,f=10,parent=A)
B(g=3,h=8,f=11, parent=A)

B(g=3,h=8,f=11, parent=A)

D(g=8,h=7,f=15,parent=B)
E(g=7,h=6,f=13,parent=B)

7
C(g=7,h=8,f=15, parent=A)
K(g=9,h=3,f=12,parent=G)
D(g=8,h=7,f=15,parent=B)
E(g=7,h=6,f=13,parent=B)
A(g=0, h=9, f=9)
G(g=6,h=4,f=10,parent=A)
B(g=3,h=8,f=11, parent=A)


Vì trong tập open, K có f nhỏ nhất nên lất làm current
8
C(g=7,h=8,f=15, parent=A)
D(g=8,h=7,f=15,parent=B)
E(g=7,h=6,f=13,parent=B)
A(g=0, h=9, f=9)
G(g=6,h=4,f=10,parent=A)
B(g=3,h=8,f=11, parent=A)
K(g=9,h=3,f=12,parent=G)
D(g=12,h=7,f=19,parent=K)
L(g=16,h=0,f=16,parent=K)

9
C(g=7,h=8,f=15, parent=A)
D(g=8,h=7,f=15,parent=B)
E(g=7,h=6,f=13,parent=B)
L(g=16,h=0,f=16,parent=K)
A(g=0, h=9, f=9)
G(g=6,h=4,f=10,parent=A)
B(g=3,h=8,f=11, parent=A)
K(g=9,h=3,f=12,parent=G)


Vì trong tập open, E có f nhỏ nhất nên lất làm current
10
C(g=7,h=8,f=15, parent=A)
D(g=8,h=7,f=15,parent=B)
L(g=16,h=0,f=16,parent=K)
A(g=0, h=9, f=9)
G(g=6,h=4,f=10,parent=A)
B(g=3,h=8,f=11, parent=A)
K(g=9,h=3,f=12,parent=G)
E(g=7,h=6,f=13,parent=B)

E(g=7,h=6,f=13,parent=B)

F(g=8,h=5,f=13,parent=E)
H(g=15,h=4,f=19,parent=E)

11
C(g=7,h=8,f=15, parent=A)
D(g=8,h=7,f=15,parent=B)
L(g=16,h=0,f=16,parent=K)
F(g=8,h=5,f=13,parent=E)
H(g=15,h=4,f=19,parent=E)
A(g=0, h=9, f=9)
G(g=6,h=4,f=10,parent=A)
B(g=3,h=8,f=11, parent=A)
K(g=9,h=3,f=12,parent=G)
E(g=7,h=6,f=13,parent=B)


Vì trong tập open, F có f nhỏ nhất nên lất làm current
12
C(g=7,h=8,f=15, parent=A)
D(g=8,h=7,f=15,parent=B)
L(g=16,h=0,f=16,parent=K)
H(g=15,h=4,f=19,parent=E)
A(g=0, h=9, f=9)
G(g=6,h=4,f=10,parent=A)
B(g=3,h=8,f=11, parent=A)
K(g=9,h=3,f=12,parent=G)
E(g=7,h=6,f=13,parent=B)
F(g=8,h=5,f=13,parent=E)

L(g=10,h=0,f=10,parent=F)
Vì L trong neighbor có g < L trong open, nên thay L trong open bằng L trong neighbor
13
C(g=7,h=8,f=15, parent=A)
D(g=8,h=7,f=15,parent=B)
L(g=10,h=0,f=10,parent=F)
H(g=15,h=4,f=19,parent=E)
A(g=0, h=9, f=9)
G(g=6,h=4,f=10,parent=A)
B(g=3,h=8,f=11, parent=A)
K(g=9,h=3,f=12,parent=G)
E(g=7,h=6,f=13,parent=B)
F(g=8,h=5,f=13,parent=E)


Vì trong tập open, L có f nhỏ nhất nên lất làm current
14
C(g=7,h=8,f=15, parent=A)
D(g=8,h=7,f=15,parent=B)
H(g=15,h=4,f=19,parent=E)
A(g=0, h=9, f=9)
G(g=6,h=4,f=10,parent=A)
B(g=3,h=8,f=11, parent=A)
K(g=9,h=3,f=12,parent=G)
E(g=7,h=6,f=13,parent=B)
F(g=8,h=5,f=13,parent=E)
L(g=10,h=0,f=10,parent=F)

Vì L là điểm end. Nên thuật toán kết thúc. Truy ngược đường đi theo parent ta có:
A -> B -> E -> F -> L

Nhìn vào cách chạy thuật toán trong bảng trên, mình mong là các bạn đã hiểu được thuật giải A* hoạt động như thế nào.
Và cũng trong một khoảng thời gian rảnh rỗi và có hứng thú, mình cũng đã viết 1 đoạn chương trình bằng javascript hiện thực hóa thuật giải A* này trong việc tìm đường đi trong ma trận.

Code mình đã up sẵn lên github ở đây. Bạn chỉ cần clone về và chạy thôi nhé.
Cám ơn các bạn đã xem bài viết này của mình. Nếu có thắc mắc gì thì cứ comment vào blog. Nếu được mình sẽ giải đáp.
Share:

Thứ Sáu, 23 tháng 11, 2018

Cài đặt K-Nearest Neigbor với Python

Hi mọi người, hôm nay mình sẽ cài đặt thử thuật giải KNN với Python. Cũng như ở bài trước, chúng ta đã thử cài đặt NN với Python, mặc dù thuật toán cùi bắp nhưng vẫn có kết quả dự đoán khá ngon (38.6%). Lần này, để áp dụng KNN giải bài toán classification trên CIFAR-10 xem như thế nào. Để tìm hyperparameter K trong thuật toán này, mình sẽ xài chiến lược Cross Validation để tìm. Nhưng vì mình lười chạy thử vì đòi hỏi tài nguyên + thời gian + những suy tư trăn trở, mình mạn phép được lấy kết quả từ CS231n. Theo đó, K=7 là tối ưu dựa trên Cross Validation. Ok, vậy đã có K=7. Quá đơn giản mà không tốn nhiều công sức, chúng ta sẽ bước vào code. Sử dụng code của bài trước, ta đổi lại hàm tìm phần tử gần nhất.
def predict(self, X):   
    Ypred = np.zeros(num_test, dtype = self.ytr.dtype)    
    for i in xrange(num_test):
      print i     
      distances = np.sum(np.abs(self.Xtr - X[i,:]), axis = 1)
      k=7
      min_indexes = np.argpartition(distances, k)[:k] # vị trí k ảnh gần nhất
      yget = self.ytr[min_indexes] # yget chứa nhãn của k ảnh gần nhất
      c = Counter(yget).most_common(1) # lấy ra nhãn xuất hiện nhiều nhất trong yget
      Ypred[i] = c[0][0] # gán giá trị nhãn đó cho kết quả
    return Ypred
Lưu ý là, để chạy được hàm Counter, các bạn phải thêm thư viện vào bằng dòng code sau đây:
from collections import Counter
Sau khi để máy chạy một hồi, kết quả bạn thu được sẽ là: 37,65%. What the fuck????? Có gì đó sai sai ở đây, KNN dự đoán thua NN??? Đó là cảm giác của mình sau khi chạy xong code ở trên. Sau một hồi xem xét, thì hóa ra lỗi là ở đoạn code sau:
c = Counter(yget).most_common(1)
Ypred[i] = c[0][0]
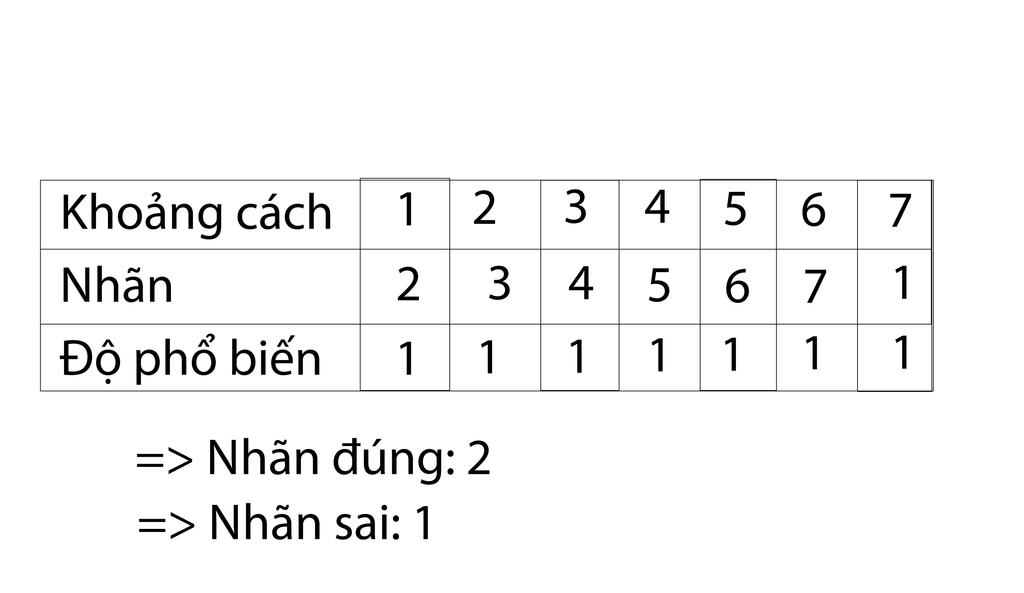
Oái ăm là vầy, nếu như tất cả các nhãn trong yget xuất hiện phổ biến ngang nhau, thì đoạn code trên sẽ trả về nhãn có giá trị nhỏ nhất.
Trường hợp sai
Như các bạn thấy, bức hình gần nhất có nhãn là "2". Nhưng đoạn code trên lại trả về nhãn "1", có thể vì nó sort hay sao đó để tìm mình cũng ko rõ, dẫn đến sai kết quả. Vì lí do này, mình có bổ sung thêm 1 số dòng code để giải.
def predict(self, X,k):
    num_test = X.shape[0]
    Ypred = np.zeros(num_test, dtype = self.ytr.dtype)
    for i in xrange(num_test):
      print i
      distances = np.sum(np.abs(self.Xtr - X[i,:]), axis = 1)      
      min_indexes = np.argpartition(distances, k)[:k] 
      yget = self.ytr[min_indexes]
      c = Counter(yget).most_common(k)
      result = c[0][0]
      if c[0][1]==1:
        k = 1
        min_indexes = np.argpartition(distances, k)[:k]
        yget = self.ytr[min_indexes]
        c = Counter(yget).most_common(k)
        result = c[0][0]
      else:
        i = 0
        while i<len(c)-1 and c[i][1]==c[i+1][1]:
          i = i+1
        if i!=0:            
          result = c[0][0]
          k2 = 1
          ind2 = np.argpartition(distances, k2)[:k2]
          yget2 = self.ytr[ind2]
          c2 = Counter(yget2).most_common(1)
          for y in range(0,i):
            if c[i][0]==c2[0][0]:
              result = c[i][0]
      Ypred[i] = result 
    return Ypred
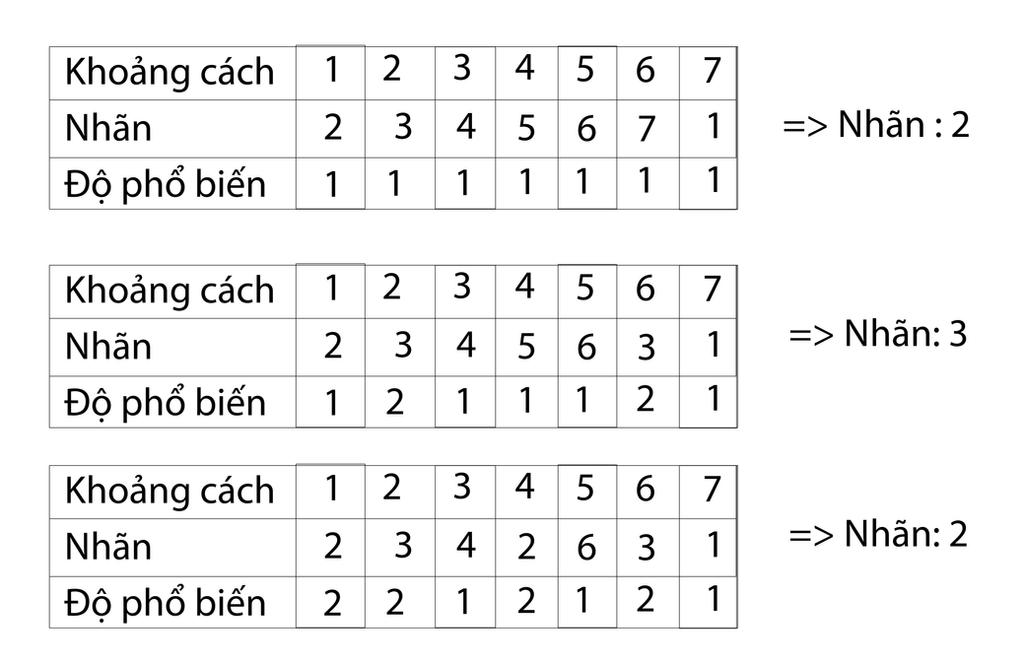
Nhìn thì có vẻ rối, nhưng cơ bản đoạn code trên giải quyết những trường hợp sau:
các trường hợp
Và sau khi dành thời gian để chạy thử code, kết quả ra là 38,26%. Vẫn thấp hơn NN các bạn ạ :'( Cuộc đời đúng là không biết lúc nào mới được giải thoát. Sau bao lần cài đặt và chạy thử, kết cục vẫn là một con số cùi bắp. Nhưng lý do tại sao KNN lại thấp hơn NN, mình nghĩ có 3 khả năng xảy ra ở đây: Khả năng 1: Quá trình chạy Cross Validation của CS231n đã sai. Khả năng này thì xác xuất xảy ra là 0.001%. Vì đây là bài giảng của Stanford, khó mà sai được. Khả năng 2: Code của mình sai :'( Khả năng này cũng khó xảy ra lắm. chắc tầm 20%. Khả năng 3: K=7 không tối ưu bằng K=1 trên tập test. Đây cũng là điều dễ hiểu, vì Cross Validation được thử nghiệm trên tập train chia nhỏ. Nên việc thử nghiệm trên tập test ko giống cũng có thể xảy ra. Khả năng này tầm 30-40%. Ok, mặc dù quá trình cài đặt và chạy thử không ra gì. Nhưng chúng ta ít nhất cũng đã thực hiện hóa được thuật toán KNN trên CIFAR-10. Một thành tích đáng được nhà nước và các đoàn thể tặng huân chưa. Một lần nữa, xin được vỗ tay cho thành công ngày hôm nay. Code bài này mình cũng đã up lên đây, bạn có thể lên để tải về chạy thử.
Share:
Được tạo bởi Blogger.